Opus 5.5 и GPT-6 Astra
Сравнение в Claude Code и Codex: пеликаны в SVG, 3D-сцены, задачи с кодом и стоимость результата.
Claude Code и Codex: что именно сравниваем
Opus 5.5 и GPT-6 Astra решают похожие задачи: пишут код, разбираются в проекте, создают интерфейсы и управляют инструментами. Но для разработчика результат складывается из двух частей: возможностей модели и среды, в которой она работает.
Claude Code даёт модели доступ к файлам, терминалу и подключённым инструментам. Codex выполняет ту же роль в экосистеме OpenAI. Если одному агенту доступен Blender, а другому только редактор кода, сравнение отражает ещё и эту разницу.
Поэтому ниже у каждого примера указаны модели, режимы и источник. Начнём с задач, где результат можно увидеть: SVG-рисунка и 3D-сцены. Затем посмотрим на оценки работы с кодом и цену API.
Pelican Test: пеликан на велосипеде
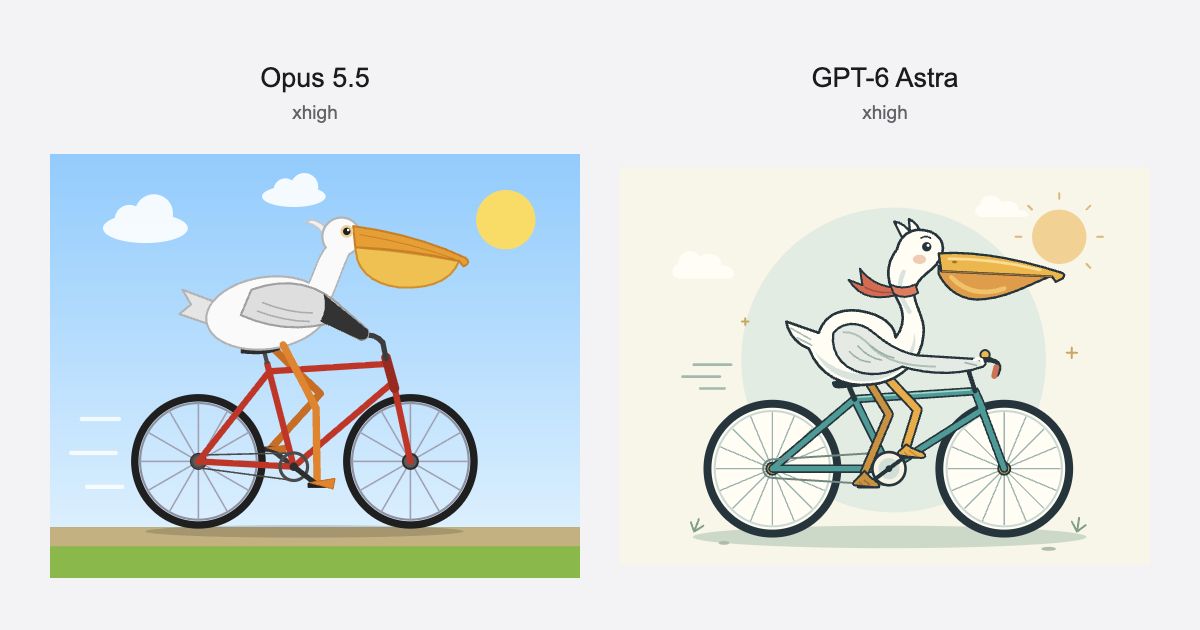
Pelican Test проверяет, как модель связывает изображение с движением: птица должна ехать на велосипеде, а колёса, педали и лапы должны работать вместе. Ниже две анимации из публичной коллекции Pelican Benchmark. Обе карточки содержат одинаковое задание: создать самостоятельный HTML-файл с двумерной SVG-анимацией пеликана на велосипеде.
Opus построил простую мультяшную сцену: голубое небо, зелёные холмы и крупная птица. Astra добавила оформление целой страницы с заголовком, морским пейзажем и более сдержанной палитрой. В движении стоит следить за положением лап относительно педалей, вращением колёс и тем, как повторяется цикл. Детали фона не заменяют согласованную механику.
Условия указаны авторами публикаций: один запрос, без последующих правок, режим High у Opus и XHigh у Astra. Вычислительный бюджет различается. Эти записи позволяют сравнить конкретные работы, но не доказывают общее превосходство одной модели. Запись экрана также не подходит для измерения частоты кадров исходной сцены.
У Simon Willison есть отдельная, статичная версия задания: получить SVG-рисунок. Её результат полезен для другого вопроса: сколько стоит законченный артефакт и всегда ли увеличение бюджета рассуждения помогает. Следующая таблица относится именно к статичным рисункам из его галерей, а не к двум анимациям выше.
| Режим | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| high | 3 366 выходных токенов · $0,0674 | 3 671 выходной токен · $0,1837 |
| xhigh | 11 977 выходных токенов · $0,2396 | 6 766 выходных токенов · $0,3385 |
| max | SVG не получен · $2,5601 за попытку | 12 638 выходных токенов · $0,6321 |
Самая показательная разница проявилась в max. По описанию Willison, Opus дважды израсходовал лимит 128 тысяч выходных токенов на рассуждение и не выдал SVG. Astra на max завершила рисунок. У Opus работали более низкие режимы, включая xhigh. В этом тесте увеличение бюджета рассуждения ухудшило практический результат: ответ стал дороже, а готового файла не оказалось.
Пеликан хорошо выявляет визуальную связность и способность довести небольшой артефакт до конца. Он не измеряет качество большого приложения: удачная анимация ещё ничего не говорит о миграции базы данных или сохранении авторизации после рефакторинга.
3D-тест: одна лошадь, четыре режима
Aditya Jhajharia опубликовал четыре варианта одной 3D-задачи: GPT-6 Astra в режимах Light и Very High, Opus 5.5 в Low и Max. На ролике сопоставлены стилизованные лошади с анимацией галопа.
Разницу видно уже по силуэту. У Astra получились более округлые формы и отдельная площадка под моделью. Opus Low дал предельно упрощённую угловатую фигуру. В Opus Max появилась более насыщенная сцена: окружение, трава и деревья. При этом богатство фона само по себе не отвечает на главный вопрос задания: насколько убедительно движется лошадь.
В ролике можно сопоставить согласованность ног, устойчивость корпуса и повторение цикла. У Astra силуэт читается даже при небольшой детализации. У Opus Max насыщенное окружение привлекает внимание, но оценивать галоп нужно отдельно от травы, деревьев и освещения. Переключение между режимами заметно меняет характер сцены, поэтому подписи здесь существенны.
Полный исходный запрос и история правок в публикации не раскрыты. Поэтому этот пример показывает конкретные полученные сцены. Считать его точным измерением разницы между архитектурами моделей нельзя; зато он наглядно показывает, насколько режим запуска влияет на детализацию результата.
Желейные лимоны: интерактивная сцена Astra
В демонстрации Vib3Coded Astra создала дерево с желейными лимонами на WebGPU. Автор показывает, как ветви качаются, плоды срываются мышью, падают, сжимаются и продолжают покачиваться после столкновения с поверхностью.
Здесь интересен переход от картинки к поведению. Нужно совместить материал плодов, деформацию, столкновения и действия пользователя. В видео видны реакция дерева на движение и изменение формы лимонов при падении. По словам автора, сцена получена по одному запросу; журнал работы и исходный код в посте не приведены.
Этот пример полезен рядом с тестом лошади: визуальные задачи не заканчиваются созданием формы. Для интерактивной сцены результатом становится работающий набор правил. Красивый первый кадр и удобное, устойчивое поведение требуют отдельной оценки.
Что показывают тесты на работу с кодом
В анонсе Opus 5.5 опубликованы результаты нескольких наборов задач. В терминальном тесте выше оценка Opus, в автоматизации бизнес-процессов выше оценка Astra.
| Тест | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0: работа в терминале | 66,4% | 57,9% |
| FrontierCode v1.1 Main: задачи с кодом | 54,4% | 53,3% |
| AutomationBench: бизнес-процессы | 40,0% | 41,4% |
Эти числа относятся к разным процедурам. В Terminal-Bench у Opus указан xhigh, для Astra указан high; показатели Astra взяты из публикации OpenAI. В некоторых оценках Anthropic при срабатывании защит использовала другие Claude-модели. AutomationBench проводила Zapier без таких подмен.
У таблицы нет единого победителя. Разница в FrontierCode составляет 1,1 процентного пункта, а более заметный отрыв в Terminal-Bench относится именно к терминальным заданиям. Для команды, которая чаще исправляет код и запускает команды, эта строка ближе к работе, чем впечатление от 3D-ролика. Но она всё равно не заменяет проверку изменения на своём проекте.
Стоимость: от токена к готовой задаче
| Параметр | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Контекстное окно | 1 000 000 токенов | 1 050 000 токенов |
| Максимальный вывод | 128 000 токенов | 128 000 токенов |
| Вход, за 1 млн токенов | $4 | $10 |
| Выход, за 1 млн токенов | $20 | $50 |
Источники: документация Anthropic и карточка GPT-6 Astra. Это цены API, а не подписок Claude или ChatGPT. Для Astra при входе свыше 272 тысяч токенов действуют коэффициенты ×2 на вход и чтение кэша, ×1,5 на выход. Кэш и ускоренные режимы также меняют расчёт.
При одинаковом расходе стандартных входных и выходных токенов Opus дешевле в 2,5 раза. Например, 100 тысяч некэшированных входных и 20 тысяч выходных токенов стоят $0,80 у Opus и $2 у Astra. Это расчёт по тарифам, без инструментов и дополнительных режимов.
Однако Pelican показывает, почему тариф не равен цене результата. В xhigh Opus потратил больше выходных токенов, но ответ всё ещё стоил меньше. В max он израсходовал $2,56 и не выдал файл, тогда как Astra завершила SVG примерно за $0,63. Неудачная попытка может перечеркнуть преимущество более дешёвого токена.
В разработке к этому добавляются время человека и повторные исправления. Если агент быстро написал код, но сломал старый сценарий, работа ещё не завершена. Считать полезнее стоимость принятого изменения: с проверкой, исправлениями и сохранением нужного поведения.
Почему рабочая среда меняет результат
В сравнении motion-видео kirill sh автор предпочёл результат Opus. Затем он раскрыл условия запуска: один компьютер, одинаковый запрос, максимальное рассуждение, отключённая память, Blender MCP и аудиоинструменты. Opus выбрал Blender; Astra при том же доступе пошла другим путём.
По записи автора, Codex работал около 35 минут, а Claude Code около полутора часов, без учёта рендера. Визуальное предпочтение автора и скорость выполнения в этом примере указывают в разные стороны. Это ещё одна причина разделять качество артефакта, время и расход.
В реальном проекте стоит фиксировать не только название модели, но и версию инструмента, доступные программы, инструкции и разрешения. Интерфейс проверяют в браузере. Исправление проверяют воспроизводимым сценарием и нужными тестами. Тогда сравниваются завершённые изменения с понятным критерием приёмки.
Что выбрать
У Opus 5.5 ниже базовая стоимость API и выше опубликованный результат в Terminal-Bench. Это весомые аргументы для регулярной работы с файлами, командами и типовыми изменениями. При этом максимальный режим рассуждения не стоит автоматически считать лучшим: Pelican даёт конкретный контрпример.
У Astra в приведённом Pelican-тесте max завершил работу, а интерактивная сцена с лимонами показывает удачный результат в задаче на поведение и графику. Это основания рассматривать модель для сложных визуальных и многошаговых задач; отдельная эффектная сцена не устанавливает общее превосходство.
Для постоянной работы выбирайте сочетание модели и среды по результатам задач своей команды. Учитывайте число принятых изменений и переделок, стоимость вызовов и время ручной проверки. Эти показатели лучше объясняют пользу инструмента, чем один красивый кадр или самое высокое место в отдельной таблице.
Источники
Проверено . Разбор официальных данных и опубликованных работ. Собственные прогоны моделей на общем репозитории не проводились.
- Anthropic: карточка Claude Opus 5.5
- OpenAI: карточка GPT-6 Astra и тарифы API
- Anthropic: анонс Opus 5.5 и примечания к тестам
- Claude Code: возможности рабочей среды
- OpenAI: модели в Codex и рекомендации по выбору
- Pelican Benchmark: анимация Claude Opus 5.5 High
- Pelican Benchmark: анимация GPT-6 Astra XHigh
- Simon Willison: Pelican Test и поведение Opus 5.5 max
- Simon Willison: исходные SVG Claude и расход токенов
- Simon Willison: исходные SVG GPT и расход токенов
- Aditya Jhajharia: 3D-сравнение Astra и Opus в четырёх режимах
- Vib3Coded: интерактивное дерево с желейными лимонами
- kirill sh: сравнение motion-видео
- kirill sh: инструменты, настройки и время